希少な土地被覆クラスの層別サンプリング
希少なクラスを表し、包含確率を保存し、根拠のある精度と面積の推定をサポートする独立した確率サンプルを設計します。
評価目標を設定する
土地被覆マップは全体的な精度が高くても、小さいながらも重要なクラスではパフォーマンスが低下することがあります。まれな湿地帯や撹乱された地域は、全体にはほとんど寄与しないかもしれませんが、プロジェクトにとっては非常に重要です。サンプル設計を選択し、利用可能なレビュー作業を割り当てる前に、評価で全体的な精度、特定のクラス、領域推定、または変更検出を優先するかどうかを定義します。
サンプリング単位と層を定義する
サンプル単位がラスター セルであるか、固定面積の標本区であるか、または別の明確に定義された空間単位であるかを指定します。マップされたラベルが間違っている可能性があることを認識しながら、マップされたクラスなどの文書化された情報から層を確立します。母集団のすべての関連部分に既知の選択のチャンスがあることを確認します。アクセス可能な道路のそばにのみ選択された便利なポイントは、広く分布しているため確率サンプルになりません。
明確な目的を持って観測を割り当てます
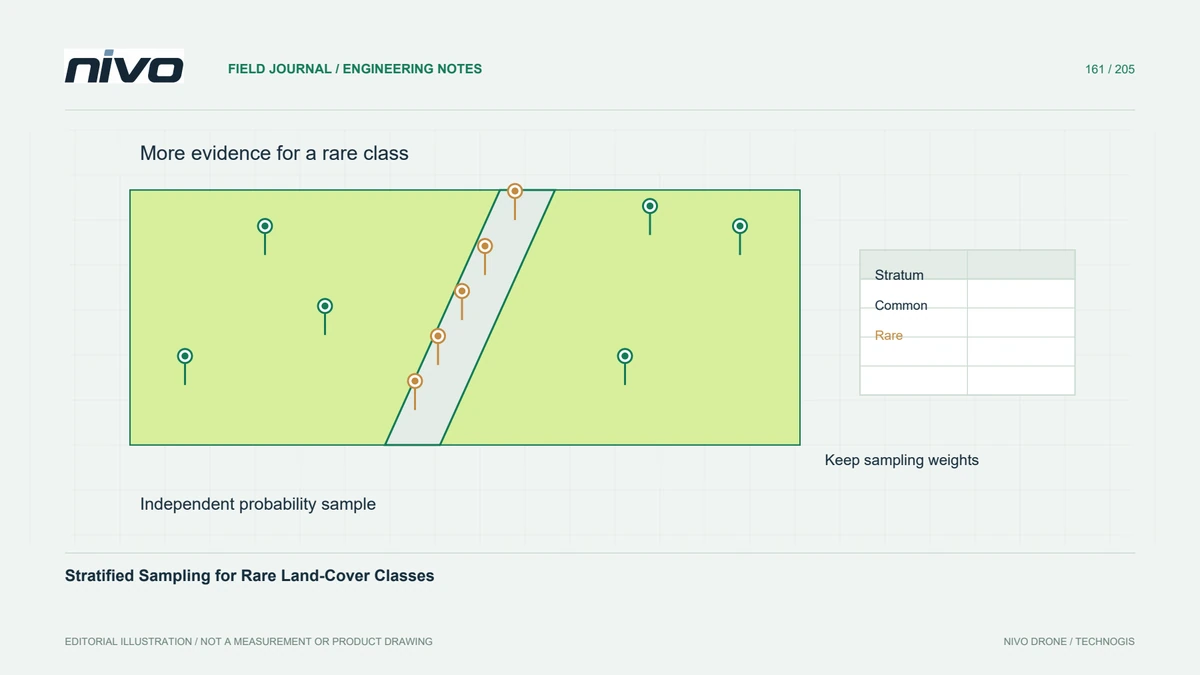
層別化により、単純な面積比例サンプルよりも多くのレビュー労力を希少クラスに割り当てることができます。割り当ては、必要な見積もり、予想される変動性、および実際的な制約に従う必要があります。すべての層でユニットの数と選択確率を維持します。小さなクラスをオーバーサンプリングすることは便利ですが、サンプリングされたすべての観測値を総面積を同等に表すものとして扱うと、最終的なサマリーが歪む可能性があります。
参照解釈を独立したものに保つ
評価対象の単位の空間解像度、日付、解釈品質に適した参照証拠を使用します。検証の観察をモデルのトレーニングから独立させ、合意されたプロトコルを通じて曖昧なケースを記録します。本物の土地被覆の変化後に撮影された現地の写真は、以前の地図のラベルを確立していない可能性があります。マップまたは参照インタープリターのどちらかが常に正しいと仮定するのではなく、不一致を注意深く検討してください。
サンプリング設計による分析
仮想のプランテーション生息地目録では、文書化された各標本層内でランダムにサンプルを抽出し、狭い河畔階級を有意義に評価するのに十分な観察を確保します。一貫した参照ルールを使用してサイトを検査し、アクセスできないケースや不確実なケースを便利な場所に黙って置き換えることなく記録します。生のサンプル割合を不偏の面積推定値として提示するのではなく、適切な重み付けや不確実性レポートなど、サンプリング設計に沿った分析を適用します。
不確実性と例外を文書化する
サンプリングフレーム、層、選択手順、包含情報、参照プロトコル、ラベル付き観察、および分析方法を提供します。全体の要約とともにクラス固有のパフォーマンスを報告し、不確実性や設計からの逸脱を説明します。受け入れは、好ましい例のコレクションではなく、マップの追跡可能な評価を確立する必要があります。レアクラスのレビューは、マップがどこまで信頼できるか、どこでより多くの証拠が必要かについての正直な決定をサポートする場合に最も役立ちます。